MARKETING DATA · PYTHON BASIC · 2026-08-02
Source ↗이번에는 수강생에서 강사로, 마케팅 데이터 분석을 위한 Python 기초 강의를 준비하게 됐다.
같은 부트캠프 수강생들을 대상으로 강의를 준비하면서, 이번에는 무엇을 알려줄지보다 어떻게 설명해야 어렵지 않게 이해할 수 있을지가 더 고민이었다. 실제로 Python이라는 이름만 들어도 부담을 느끼는 분들이 생각보다 많았기 때문이다.
그래서 문법을 하나씩 설명하기보다, 실제 마케팅 데이터를 불러오고 지표를 계산하는 흐름 속에서 필요한 문법을 자연스럽게 익힐 수 있도록 강의를 구성했다. 이번 글에서는 Python 기초부터 Pandas, 마케팅 지표 계산, GroupBy와 Pivot을 활용한 성과 비교, 그리고 시각화까지 마케터에게 필요한 데이터 분석 흐름을 순서대로 정리해보려고 한다.
Python을 배우는 목적은 코드를 많이 아는 것이 아니다.
데이터를 직접 확인하고, 숫자의 의미를 해석하고, 다음 마케팅 액션으로 연결하는 분석 흐름을 이해하는 것이 핵심이다.
1. 왜 마케터에게 Python이 필요한가?
데이터를 활용하는 마케터라면 Python을 한 번쯤은 접하게 됩니다. 광고 성과를 분석하거나 고객 데이터를 정리하고, 반복되는 업무를 자동화할 때 Python은 가장 많이 활용되는 도구 중 하나입니다.
하지만 처음부터 복잡한 문법을 모두 익힐 필요는 없습니다. 마케팅 데이터를 직접 불러오고, 필요한 지표를 계산하며, 결과를 해석할 수 있는 수준만 갖춰도 실무에서 활용할 수 있는 범위는 크게 넓어집니다.
이번 강의에서는 Python 자체를 깊게 배우는 것보다 마케터의 관점에서 데이터를 다루는 방법에 집중합니다. 앞으로 배울 Pandas와 시각화 역시 코드를 외우기 위한 것이 아니라, 데이터를 빠르게 확인하고 인사이트를 도출하기 위한 도구로 활용하게 됩니다.
Python을 잘하는 것이 목표가 아닙니다.
데이터를 직접 확인하고, 분석하고, 의사결정까지 연결할 수 있는 마케터가 되는 것이 이번 강의의 목표입니다.
2. 이번 글에서 다룰 내용
이번 글에서는 Python 기초 문법부터 시작해 마케팅 데이터를 확인하고, 지표를 계산하고, 성과를 비교해 인사이트를 도출하는 과정까지 하나의 흐름으로 살펴봅니다.
실제 데이터 분석 순서에 맞춰 구성했기 때문에, 각 단계를 따라가다 보면 Python을 활용한 마케팅 데이터 분석의 기본 흐름을 자연스럽게 이해할 수 있습니다.
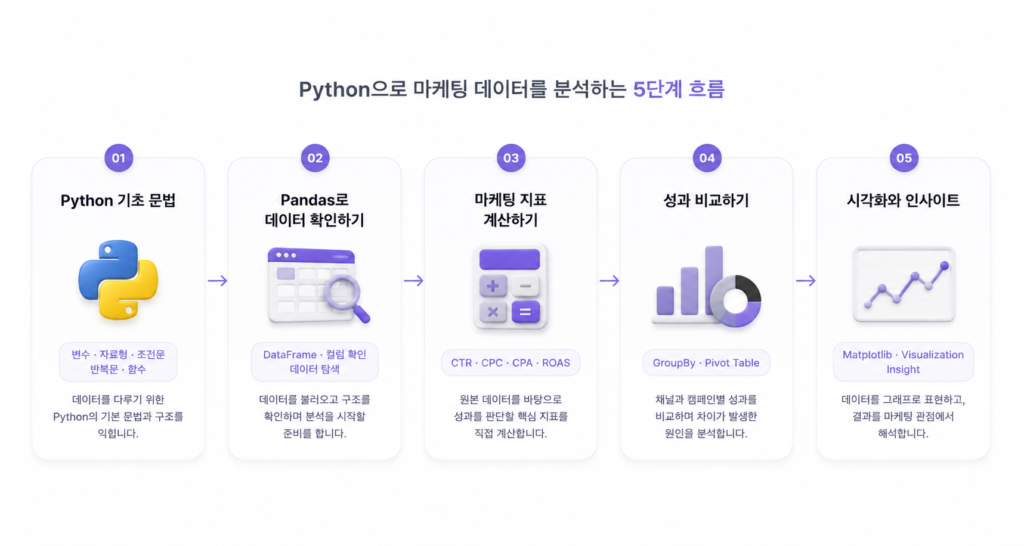
- 01 Python 기초 문법
-
변수 → 자료형 → 조건문 → 반복문 → 함수
데이터를 다루기 위한 Python의 기본 문법과 구조를 익힙니다.
- 02 Pandas로 데이터 확인하기
-
DataFrame → 컬럼 확인 → 데이터 탐색
데이터를 불러오고 구조를 확인하며 분석을 시작할 준비를 합니다.
- 03 마케팅 지표 계산하기
-
CTR → CPC → CPA → ROAS
원본 데이터를 바탕으로 성과를 판단할 핵심 지표를 직접 계산합니다.
- 04 성과 비교하기
-
GroupBy → Pivot Table
채널과 캠페인별 성과를 비교하며 차이가 발생한 원인을 분석합니다.
- 05 시각화와 인사이트
-
Matplotlib → Visualization → Insight
데이터를 그래프로 표현하고, 결과를 마케팅 관점에서 해석합니다.
3. Python 기초 문법
Python 문법은 처음에는 낯설게 느껴질 수 있습니다. 하지만 마케팅 데이터 분석에서 자주 사용하는 문법은 비교적 단순합니다. 데이터를 저장하고, 조건에 따라 분류하고, 반복해서 계산하는 구조를 이해하면 대부분의 분석을 시작할 수 있습니다.
Pandas를 활용한 데이터 분석도 Python 문법을 기반으로 동작합니다. 이번 글에서는 변수(Variable), 자료형(Data Type), 조건문(Conditional Statement), 반복문(Loop), 함수(Function)처럼 이후 데이터 분석 과정에서 계속 활용되는 핵심 문법을 먼저 살펴봅니다.
문법을 모두 외울 필요는 없습니다. 데이터를 원하는 형태로 다루기 위한 기본 도구라고 이해하면 충분합니다.
- 01 변수(Variable)와 자료형(Data Type)
-
변수는 데이터를 저장하는 공간입니다. 광고비, 클릭 수, 노출 수, 캠페인 이름처럼 분석에 필요한 값을 변수에 저장하면 이후 계산이나 비교에 반복해서 활용할 수 있습니다.
Pythoncampaign = "Meta" clicks = 1248 impressions = 58230 cost = 380000 # CTR 계산 ctr = clicks / impressions * 100 print(campaign) print(round(ctr, 2))이렇게 저장한 변수는 CTR, CPC, CPA, ROAS처럼 다양한 마케팅 지표를 계산하는 기본 데이터가 됩니다.
- 02 조건문(Conditional Statement)
-
모든 데이터를 같은 기준으로 분석하지는 않습니다. 조건문을 활용하면 성과가 좋은 캠페인만 확인하거나, 전환율이 낮은 광고만 따로 추려보는 것처럼 원하는 기준으로 데이터를 분류할 수 있습니다.
Pythonroas = 3.8 # ROAS가 3 이상이면 성과 우수 if roas >= 3: print("성과 우수") else: print("개선 필요")실제 업무에서도 조건문은 성과가 좋은 캠페인을 찾거나, 개선이 필요한 광고를 빠르게 선별할 때 자주 활용됩니다.
- 03 반복문(Loop)과 함수(Function)
-
채널과 캠페인이 많아질수록 같은 계산을 반복해야 하는 경우도 함께 늘어납니다. 반복문은 동일한 작업을 자동으로 수행하고, 함수는 자주 사용하는 계산을 하나의 코드로 만들어 여러 번 재사용할 수 있도록 도와줍니다.
Pythonchannels = ["Meta", "Google", "Naver"] # 채널별 이름 출력 for channel in channels: print(channel) # CTR 계산 함수 def calculate_ctr(clicks, impressions): return clicks / impressions * 100 print(calculate_ctr(1248, 58230))이후 Pandas에서도 이러한 문법을 함께 활용해 데이터를 필터링하고, 새로운 컬럼을 만들고, 원하는 기준으로 데이터를 가공하게 됩니다.
4. Pandas로 데이터 확인하기
실제 업무에서는 CSV나 Excel 형태의 데이터를 전달받는 경우가 많습니다. 하지만 데이터를 바로 분석하기보다 어떤 데이터인지 먼저 이해하는 과정이 필요합니다. 컬럼은 무엇이 있는지, 데이터는 몇 개나 있는지, 비어 있는 값은 없는지부터 확인해야 이후 분석 결과도 신뢰할 수 있습니다.
Pandas는 데이터를 쉽고 빠르게 다룰 수 있도록 도와주는 Python 라이브러리입니다. 데이터를 불러오고 구조를 확인하는 것부터 필요한 데이터만 선택하는 과정까지, 대부분의 데이터 분석은 Pandas에서 시작됩니다.
데이터를 분석하기 전에 먼저 데이터를 이해해야 합니다. Pandas는 데이터를 분석하기 위한 첫 번째 출발점이라고 생각하면 됩니다.
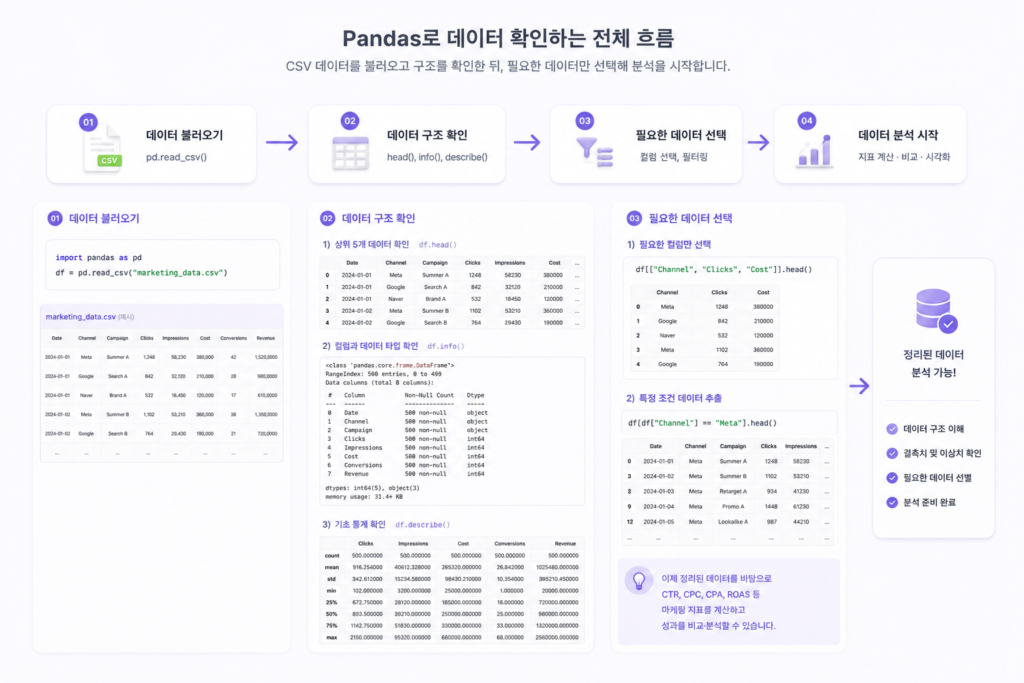
- 01 데이터 불러오기
-
가장 먼저 Pandas를 불러오고 CSV 파일을 읽어옵니다. 이후 진행하는 대부분의 데이터 분석도 이 과정에서 시작됩니다.
Pythonimport pandas as pd # CSV 파일 불러오기 df = pd.read_csv("marketing_data.csv") - 02 데이터 구조 확인하기
-
데이터를 불러왔다면 바로 분석하지 않습니다. 컬럼 구성과 데이터 개수, 데이터 타입, 결측치(Null) 여부를 먼저 확인해 분석에 사용할 수 있는 상태인지 점검합니다.
Python# 상위 5개 데이터 확인 df.head() # 컬럼과 데이터 타입 확인 df.info() # 기초 통계 확인 df.describe()이러한 과정만으로도 데이터가 정상적으로 수집되었는지, 이상치나 누락된 값은 없는지 빠르게 확인할 수 있습니다.
- 03 필요한 데이터 선택하기
-
모든 데이터를 한 번에 분석하는 경우는 거의 없습니다. 분석 목적에 맞게 필요한 컬럼만 선택하거나, 특정 조건의 데이터만 추출하면서 분석 범위를 좁혀갑니다.
Python# 필요한 컬럼만 선택 df[["Channel", "Clicks", "Cost"]] # Meta 채널 데이터만 추출 df[df["Channel"] == "Meta"]이렇게 정리한 데이터를 기반으로 CTR, CPC, CPA, ROAS 같은 마케팅 지표를 계산하고, 채널별 성과를 비교하는 분석으로 이어집니다.
5. 마케팅 지표 직접 계산하기
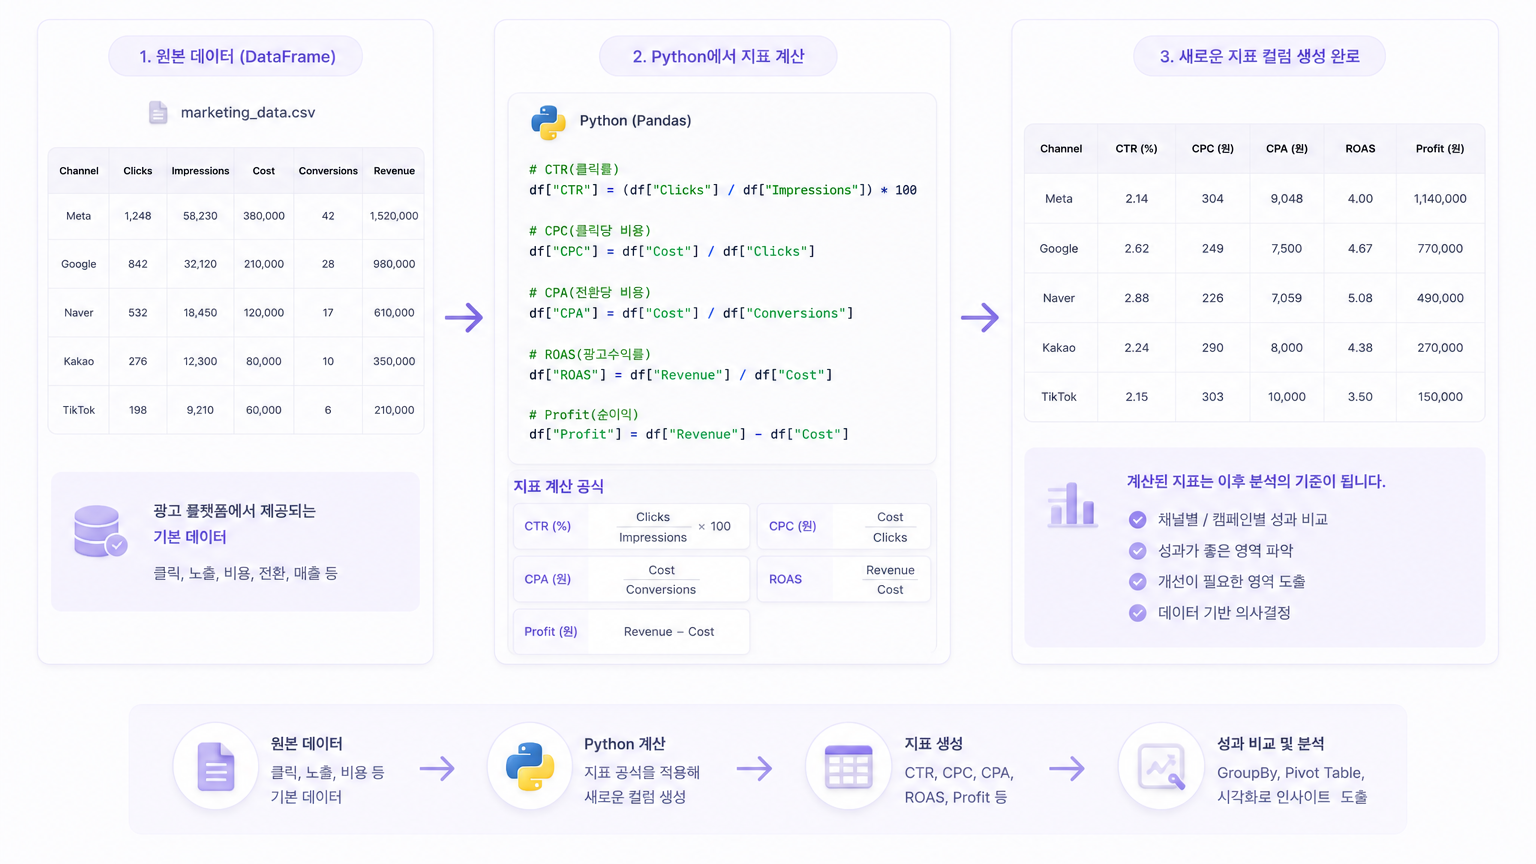
광고 플랫폼에서는 CTR, CPC, CPA, ROAS 같은 지표를 자동으로 보여줍니다. 하지만 숫자를 그대로 확인하는 것과 직접 계산해보며 지표가 만들어지는 과정을 이해하는 것은 전혀 다른 경험입니다.
Python에서는 기존 데이터에 새로운 컬럼을 추가해 원하는 지표를 직접 계산할 수 있습니다. 이렇게 만들어진 지표는 이후 성과 비교와 시각화까지 분석의 기준으로 활용됩니다.
중요한 것은 공식을 외우는 것이 아닙니다. 원본 데이터를 원하는 지표로 변환하고 해석하는 과정을 이해하는 것이 핵심입니다.
- 01 CTR(Click Through Rate) 계산하기
-
CTR은 광고를 본 사람 중 얼마나 많은 사용자가 클릭했는지를 나타내는 지표입니다. 같은 노출 수에서도 CTR이 높다면 광고 소재나 메시지가 더 많은 관심을 끌었다고 해석할 수 있습니다.
Python# CTR 계산 df["CTR"] = ( df["Clicks"] / df["Impressions"] ) * 100 df[["Channel", "CTR"]].head()계산된 CTR을 비교하면 어떤 광고 소재나 채널이 더 높은 반응을 얻었는지 빠르게 확인할 수 있습니다.
- 02 CPC와 CPA 계산하기
-
클릭을 얻기 위해 얼마를 사용했는지(CPC), 전환 한 건을 만들기 위해 얼마를 사용했는지(CPA)는 광고 효율을 판단할 때 가장 자주 활용되는 지표입니다.
Python# 클릭당 비용 df["CPC"] = df["Cost"] / df["Clicks"] # 전환당 비용 df["CPA"] = df["Cost"] / df["Conversions"]예를 들어 CTR은 높지만 CPA도 높다면, 많은 사용자가 클릭했더라도 실제 구매로는 이어지지 않았을 가능성을 함께 살펴볼 수 있습니다.
- 03 필요한 지표 직접 만들기
-
실무에서는 플랫폼에서 제공하는 지표만 사용하는 경우보다 목적에 맞는 지표를 직접 계산하는 경우도 많습니다. 필요한 컬럼을 조합하면 원하는 기준으로 데이터를 해석할 수 있습니다.
Python# 광고수익률 df["ROAS"] = df["Revenue"] / df["Cost"] # 순이익 df["Profit"] = df["Revenue"] - df["Cost"]이렇게 생성한 컬럼은 이후 GroupBy와 Pivot Table을 이용해 채널별, 캠페인별 성과를 비교하는 기준으로 활용됩니다.
6. GroupBy와 Pivot으로 성과 비교하기
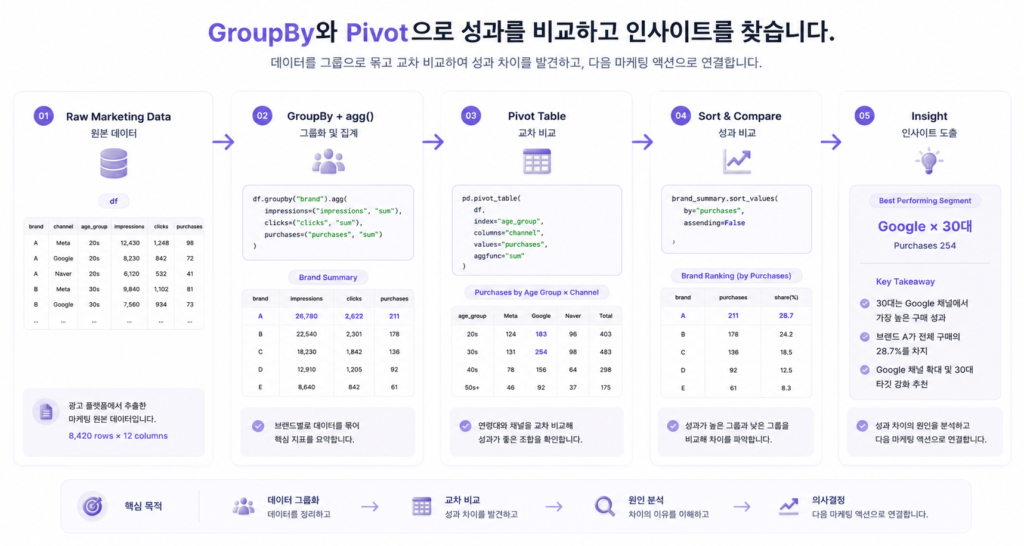
마케팅 데이터를 분석할 때는 전체 평균보다 어떤 그룹에서 성과 차이가 발생했는지를 확인하는 과정이 더 중요합니다. 채널, 브랜드, 연령대처럼 다양한 기준으로 데이터를 묶어 비교하면 어떤 전략이 효과적이었는지 훨씬 명확하게 파악할 수 있습니다.
Pandas에서는 groupby()와 agg(), 그리고 pivot_table()을 활용해
데이터를 원하는 기준으로 요약하고 성과를 비교할 수 있습니다.
데이터를 비교하는 목적은 순위를 확인하는 것이 아닙니다. 성과 차이가 발생한 이유를 발견하고 다음 마케팅 액션으로 연결하는 것이 핵심입니다.
- 01 GroupBy와 agg()로 성과 요약하기
-
먼저 데이터를 브랜드나 채널처럼 원하는 기준으로 묶은 뒤, 노출 수, 클릭 수, 구매 수 등 필요한 지표를 한 번에 집계합니다. 실무에서도 가장 많이 사용하는 데이터 요약 방식입니다.
Pythondf.groupby("brand").agg( impressions=("impressions", "sum"), clicks=("clicks", "sum"), purchases=("purchases", "sum") )이렇게 집계하면 브랜드별 성과를 한눈에 비교하며 어떤 브랜드가 가장 많은 반응을 만들었는지 빠르게 확인할 수 있습니다.
- 02 Pivot Table로 교차 비교하기
-
하나의 기준만으로는 성과를 충분히 설명하기 어려운 경우도 있습니다. Pivot Table을 활용하면 연령대와 채널처럼 여러 기준을 함께 비교해 어떤 조합에서 가장 좋은 성과가 나타났는지 확인할 수 있습니다.
Pythonpd.pivot_table( df, index="age_group", columns="channel", values="purchases", aggfunc="sum" )하나의 표에서 여러 조건을 함께 비교할 수 있기 때문에 성과가 좋은 타깃과 채널 조합을 빠르게 발견할 수 있습니다.
- 03 데이터를 비교해 인사이트 찾기
-
숫자를 정리하는 것만으로 분석은 끝나지 않습니다. 성과가 높은 그룹은 무엇이 달랐는지, 성과가 낮은 그룹은 어떤 부분을 개선해야 하는지까지 연결해야 데이터가 실제 의사결정에 활용됩니다.
Pythonbrand_summary.sort_values( by="purchases", ascending=False )이렇게 정리된 결과는 예산을 어디에 더 투자할지, 어떤 타깃과 채널을 확대할지 결정하는 근거가 되며, 다음 단계인 시각화에서도 그대로 활용됩니다.
7. 시각화에서 인사이트까지
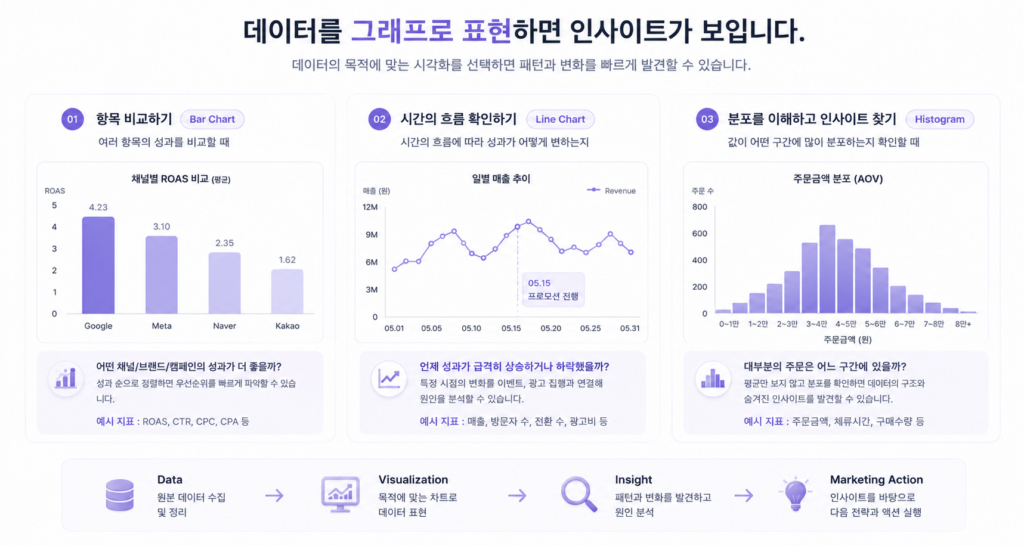
데이터를 정리하고 지표를 계산했다면 이제는 숫자를 한눈에 이해할 수 있는 형태로 표현해야 합니다. 시각화는 보기 좋은 그래프를 만드는 과정이 아니라, 데이터 속 패턴과 변화를 빠르게 발견하기 위한 분석 과정입니다.
같은 데이터라도 어떤 그래프를 선택하느냐에 따라 전달되는 메시지가 달라집니다. 비교가 필요한지, 추이를 확인해야 하는지, 분포를 살펴봐야 하는지 목적에 맞는 차트를 선택하는 것이 중요합니다.
좋은 그래프는 숫자를 예쁘게 보여주는 것이 아니라 다음 질문과 의사결정을 빠르게 이끌어내는 그래프입니다.
- 01 항목 비교하기 (Bar Chart)
-
브랜드, 광고 채널, 캠페인처럼 여러 항목의 성과를 비교할 때는 막대그래프(Bar Chart)를 가장 많이 사용합니다. 예를 들어 채널별 ROAS를 비교하면 어떤 채널에 예산을 더 투자해야 할지 빠르게 판단할 수 있습니다.
항목이 많다면 성과 순으로 정렬하면 우선적으로 확인해야 할 대상을 쉽게 찾을 수 있으며, ROAS뿐 아니라 CTR, CPC, CPA처럼 대부분의 마케팅 지표에도 동일하게 활용할 수 있습니다.
Pythonchannel_roas = ( df.groupby("Channel")["ROAS"] .mean() .sort_values(ascending=False) ) channel_roas.plot(kind="bar")그래프를 통해 단순히 어느 채널의 성과가 높은지 확인하는 것을 넘어, 왜 이러한 차이가 발생했는지 광고 소재, 타깃, 예산 배분과 함께 분석하게 됩니다.
- 02 시간의 흐름 확인하기 (Line Chart)
-
마케팅 성과는 시간에 따라 계속 변합니다. 일별 방문자 수, 주간 매출, 월별 광고비처럼 시간의 흐름을 확인할 때는 선그래프(Line Chart)를 사용합니다.
특정 날짜에 성과가 급격히 상승하거나 하락했다면 프로모션, 광고 집행, 시즌 이벤트와 연결해 원인을 함께 분석하는 경우가 많습니다.
Pythondaily_sales = ( df.groupby("Date")["Revenue"] .sum() ) daily_sales.plot(kind="line")추이를 확인하면 단순한 평균값으로는 보이지 않는 변화도 발견할 수 있으며, 이후 캠페인 일정이나 예산 운영 전략을 조정하는 근거로 활용할 수 있습니다.
- 03 분포를 이해하고 인사이트 찾기
-
평균만으로는 데이터를 제대로 이해하기 어렵습니다. 히스토그램(Histogram)은 값이 어느 구간에 많이 분포하는지 확인할 때 사용하는 대표적인 차트입니다.
예를 들어 평균 주문금액(AOV)을 분석할 때 대부분의 주문이 비슷한 금액인지, 일부 고액 주문이 평균을 높이고 있는지까지 함께 확인할 수 있습니다.
Pythondf["OrderValue"].plot( kind="hist", bins=20 )결국 시각화의 목적은 그래프를 만드는 것이 아니라 숫자 속에서 새로운 질문을 발견하는 것입니다. 그래프에서 확인한 패턴을 바탕으로 원인을 분석하고, 다음 마케팅 전략과 액션으로 연결하는 과정이 데이터 분석의 핵심입니다.
8. 강의를 준비하며 느낀 점
이번 내용을 준비하면서 가장 많이 들었던 반응은 “Python은 어려울 것 같아요.”였습니다. 아직 코드를 보기 전인데도 Python이라는 이름만 듣고 부담부터 느끼는 경우가 생각보다 많았습니다.
그래서 기존처럼 문법을 하나씩 설명하기보다, 실제 마케팅 데이터를 기준으로 필요한 문법이 왜 등장하는지부터 보여주려고 했습니다. 데이터를 불러오고, 지표를 계산하고, 성과를 비교하는 흐름을 먼저 이해하면 자연스럽게 Python 문법도 함께 익힐 수 있기 때문입니다.
같은 내용이라도 어떤 순서로 설명하느냐에 따라 받아들이는 난이도가 크게 달라진다는 점도 다시 느꼈습니다. 특히 마케터에게는 문법 자체보다 ‘이 코드가 어떤 마케팅 문제를 해결하는지’를 먼저 이해하는 것이 훨씬 중요했습니다.
기술을 설명하는 것보다 왜 이 코드가 필요한지 먼저 공감할 수 있도록 설명하는 것.
이번 내용을 준비하면서 가장 많이 고민했던 부분이었고, 앞으로도 이런 방식으로 계속 정리해보고 싶습니다.